Opus 5.5 contro GPT-6: Anthropic torna a comandare nel coding
In questo articolo
Dopo mesi difficili, Opus 5.5 riporta Anthropic davanti a tutti. Batte GPT-6 Astra sulla qualità del codice e fa durare molto di più i limiti di utilizzo. Sol e Luna? Utili, ma solo per i task piccoli.
Per coding complesso, Opus 5.5 in Claude Code è una prima scelta forte. Astra resta competitivo, Sol riduce il costo e Luna serve task semplici e ripetibili. Il calo percepito dopo Opus 4.6 e il recupero con 5.5 sono esperienza d'uso, non una regressione generale dimostrata.
In una sola settimana sono arrivati Claude Opus 5.5 e i nuovi GPT-6 Sol e Luna, che affiancano Astra. Li abbiamo messi al lavoro sui nostri progetti, e il giudizio è netto: oggi il miglior modello per programmare è Opus 5.5. Scrive codice migliore di Astra, sbaglia meno e consuma i limiti di utilizzo molto più lentamente, così con lo stesso abbonamento si lavora di più.
Anthropic è tornata in testa nel coding. OpenAI, invece, deve fare i conti con limiti che si esauriscono troppo in fretta.
Il ritorno di Anthropic: da Opus 4.6 a 5.5
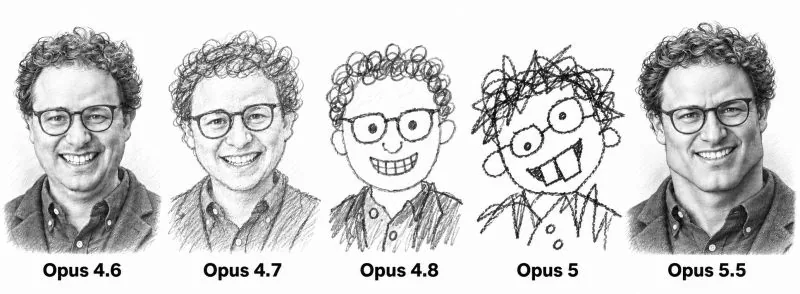
A febbraio 2026 Opus 4.6 aveva fissato lo standard. Anthropic lo presentò come un progresso in debug e code review, e chi programmava ogni giorno lo aveva confermato sul campo: era il modello di riferimento.
Poi qualcosa si è rotto. Con Opus 4.7, 4.8 e 5 la qualità nel coding è calata una versione dopo l'altra. Risposte meno incisive, patch da rifare, più giri per arrivare a un risultato accettabile. Lo abbiamo visto chiaramente sui nostri repository.
Opus 5.5 chiude questa parentesi. La qualità è tornata ai livelli di Opus 4.6 e li supera: capisce il contesto del progetto, affronta debugging ambigui e refactor estesi, e consegna codice che arriva al merge con pochi interventi.
Opus 5.5 contro Astra: vince Opus
Il confronto diretto con GPT-6 Astra, il modello di punta di OpenAI, non lascia dubbi. Sui nostri task Opus 5.5 arriva prima alla soluzione giusta, richiede meno correzioni e trova più problemi in fase di review.
I benchmark pubblici dicono la stessa cosa:
nel Coding Agent Index di Artificial Analysis Claude Code con Opus 5.5 segna 66 punti, contro 62 di Codex con Astra;
su Terminal-Bench Opus arriva al 63%, Astra al 56%;
nella code review di MacroscopeBench Opus ottiene 82,3 punti, contro 80,3 di Sol e 78,0 di Astra, e trova più bug noti di tutti.
Solo su DeepSWE Astra riesce a tenere il passo, con un pareggio al 68%.
I limiti di utilizzo: qui la differenza è enorme
Per chi lavora con un abbonamento, il punto decisivo è un altro: quanto dura. Con Opus 5.5 in Claude Code una giornata di lavoro intensa non esaurisce i limiti. Con Astra in Codex, sul piano Pro, i limiti settimanali volano via in pochi giorni.
Con l'uscita di Sol e Luna la situazione è migliorata, perché parte del lavoro si può spostare sui modelli minori. Ma Astra resta troppo affamato: ogni sessione complessa si mangia una fetta enorme del budget settimanale.
Il rapporto tra risultati e consumo decide il confronto. Opus 5.5 ottiene risultati migliori e, nell'uso reale in abbonamento, consuma molto meno. Per un team che programma ogni giorno significa più ore di lavoro utile con la stessa spesa.
Un chiarimento per chi legge i benchmark: nella prova di Artificial Analysis, eseguita via API a effort massimo, Opus usa in media più token per task di Astra (15,6 milioni contro 3,3). È un test di laboratorio, con l'effort portato al limite. Nell'uso quotidiano Opus arriva alla patch giusta con meno tentativi, ed è per questo che i limiti durano di più.
Sol e Luna: utili, ma per task piccoli
OpenAI ha affiancato ad Astra due modelli più leggeri ed economici.
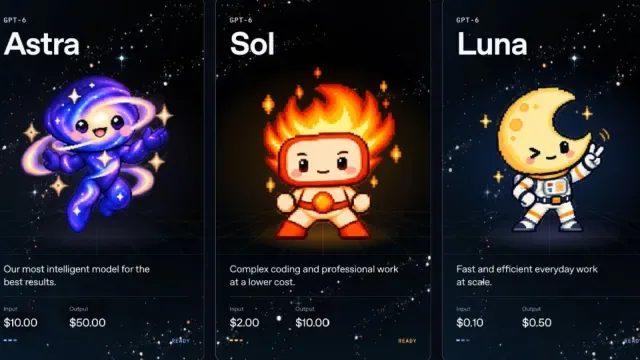
GPT-6 Sol costa 2 dollari per milione di token in input e 10 in output, un quinto di Astra. Il problema è che rispetto al Sol della generazione 5.6 è un passo indietro: meno preciso, più incline a fraintendere le richieste. Resta valido per lo sviluppo quotidiano con requisiti chiari e ben delimitati, e in code review si difende bene.
GPT-6 Luna costa appena 0,10 dollari in input e 0,50 in output. Su Terminal-Bench si ferma al 15%, quindi non va neanche considerato per un refactor o un debugging serio. Ma per attività piccole e ripetitive, come classificare issue, scrivere test semplici o applicare modifiche meccaniche, è imbattibile sul prezzo.
In sintesi: Sol e Luna sono strumenti utili, ma per i task semplici. Il lavoro difficile resta un'altra partita.
Quale scegliere
Se devi... | Usa | Perché |
|---|---|---|
Debugging complesso, refactor estesi, code review critiche | Opus 5.5 | La qualità migliore oggi sul mercato, con limiti che durano |
Lavorare nell'ecosistema OpenAI su task complessi | Astra | Buona qualità, ma occhio ai limiti settimanali |
Sviluppo quotidiano con requisiti chiari | Sol | Economico, ma meno brillante della generazione precedente |
Attività semplici, ripetitive, verificabili in automatico | Luna | Costa quasi niente |
Il nostro consiglio è semplice: per il coding che conta, Opus 5.5. Sol e Luna per alleggerire il lavoro di routine.
Anthropic ha perso la corsa per qualche mese. Con Opus 5.5 l'ha ripresa, e ha rimesso in testa la qualità.
Punti chiave
- Opus 5.5 è oggi il miglior modello per il coding: batte Astra sulla qualità e nei principali benchmark.
- Dopo il calo delle versioni 4.7, 4.8 e 5, Opus 5.5 riporta Anthropic ai livelli di Opus 4.6 e oltre.
- Con Astra i limiti settimanali del piano Pro si esauriscono troppo in fretta; con Opus 5.5 si lavora molto di più.
- GPT-6 Sol è meno preciso del Sol 5.6; Sol e Luna vanno usati per task piccoli e semplici.
Domande frequenti
Opus 5.5 è meglio di GPT-6 Astra per programmare?
Sì. Nei nostri progetti produce codice migliore con meno correzioni, e lo confermano i benchmark: 66 contro 62 nel Coding Agent Index di Artificial Analysis, 63% contro 56% su Terminal-Bench.
Quale modello fa durare di più i limiti dell'abbonamento?
Opus 5.5. Con Astra, sul piano Pro, i limiti settimanali si esauriscono in pochi giorni di lavoro intenso. Opus arriva al risultato con meno tentativi e consuma molto meno.
GPT-6 Sol è migliore del Sol precedente?
No. Nell'uso quotidiano è meno preciso del Sol 5.6. Resta utile per task chiari e ben delimitati, grazie al prezzo basso.
Quando conviene usare Luna?
Per attività piccole, numerose e facili da verificare, come classificare issue o applicare modifiche meccaniche. Non per debugging o refactor.
Fonti
- Anthropic, lancio Claude Opus 4.6
- Anthropic, note di rilascio Claude Platform
- Anthropic, documentazione Claude Opus 5.5
- OpenAI, prezzi API
- OpenAI, documentazione GPT-6 Astra
- OpenAI, documentazione GPT-6 Sol
- OpenAI, documentazione GPT-6 Luna
- OpenAI, lancio GPT-6 Sol e Luna
- Artificial Analysis, Claude Code vs Codex
- Macroscope, benchmark di code review