Jev di TypeSafe AI: cosa può fare davvero per la tua azienda
In questo articolo
Jev prende decisioni strutturate per il software. Scopri cosa fa, dove può essere utile e quali limiti valutare rispetto ai modelli AI generativi.
Jev è un modello di TypeSafe AI progettato per restituire decisioni strutturate: scelte, punteggi e probabilità. Può essere valutato per classificare e indirizzare richieste nei processi aziendali. Non genera testo libero e può sbagliare: la sua utilità dipende da dati, criteri e controlli del progetto.
Una richiesta arriva all’assistenza: «Da stamattina il gestionale si blocca quando confermo un ordine. Abbiamo le spedizioni ferme». Prima di scrivere una risposta, l’azienda deve capire a chi assegnarla, quanto è urgente e quali informazioni mancano. È un esempio del lavoro poco visibile che rende utile l’intelligenza artificiale nei processi quotidiani.
Jev affronta proprio questo spazio: giudizi circoscritti che un programma può usare per proseguire un’attività. Per un professionista o un’azienda, comprenderne il valore significa distinguere la qualità della decisione dalla capacità di sostenere una conversazione.
Questa analisi considera la documentazione disponibile al 24 settembre 2026 e Jev 1.13. Confronta capacità e impostazione delle principali alternative selezionate, senza attribuire quote di mercato o presentare un benchmark indipendente che non abbiamo eseguito.
TypeSafe AI e Jev, spiegati semplicemente
TypeSafe AI è l’azienda che ha presentato Jev il 15 settembre 2026. Lo definisce il primo dei propri “System One Models”, progettati per decisioni rapide e strutturate. Nel suo annuncio di lancio descrive un’architettura, un sistema di elaborazione parallela e un addestramento chiamato Reinforcement Learning for Calibrated Decisions, o RLCD.
Jev è un modello da integrare nel software attraverso un’API. Il programma gli fornisce il contesto e stabilisce quali risposte sono ammesse. Il risultato alimenta le istruzioni dell’applicazione; l’esecuzione delle azioni resta al software che lo utilizza. “System One” è il nome scelto dal produttore per questa impostazione, non una certificazione di affidabilità.
Le domande disponibili appartengono a tre tipi:
Choice seleziona un’opzione fra quelle definite: per esempio il reparto destinatario.
Score valuta il contenuto secondo livelli descritti: per esempio la gravità di un problema.
Noul restituisce una probabilità fra zero e uno per una domanda sì/no: per esempio se il messaggio segnala un blocco operativo.
Un modello linguistico generativo può produrre una risposta nuova parola dopo parola. Jev lavora invece entro lo spazio di decisione predisposto. Questa specializzazione ne delimita sia l’utilità sia i limiti: non gli si chiede di redigere una proposta commerciale o una spiegazione articolata.
Che cosa può fare in azienda
Torniamo alla richiesta sul gestionale. Un possibile progetto gli passerebbe il testo, il servizio interessato e una breve descrizione delle categorie interne. Gli chiederebbe separatamente il reparto, la gravità descritta e se il cliente segnala un’interruzione del lavoro. Si tratta di un esempio progettuale, non di una prova eseguita su Jev.
Il software potrebbe poi creare il ticket e assegnarlo alla coda appropriata. Una regola aziendale stabilirebbe che le interruzioni operative richiedono una notifica al responsabile. Un modello generativo potrebbe preparare una risposta da approvare. Nessuno di questi passaggi dovrebbe essere confuso con una funzione che Jev esegue autonomamente.
Consideriamo però un altro messaggio: «Non riesco più a fare come ieri, potete controllare?». Il problema potrebbe riguardare il gestionale, un permesso o una procedura cambiata. Forzarlo in una categoria darebbe un risultato ordinato, ma poco utile. Il progetto dovrebbe prevedere una categoria “informazioni insufficienti” e la possibilità di chiedere chiarimenti.
La stessa logica può essere valutata per organizzare segnalazioni, scegliere fra procedure disponibili o stimare la pertinenza di documenti già recuperati. Il punto di partenza è sempre una domanda verificabile: quali errori accettiamo, chi li rileva e che cosa succede quando il sistema non sa decidere?
Dove Jev offre vantaggi
Il primo vantaggio potenziale è la semplicità del risultato da utilizzare: categorie e valori previsti dall’applicazione. Il secondo è la possibilità di valutare più domande indipendenti sul medesimo contesto in parallelo. Per un processo composto da molte piccole valutazioni, questa impostazione merita un confronto con le soluzioni già in uso.
Choice e Score restituiscono distribuzioni di probabilità e un valore di confidence derivato dalla loro forma; Noul restituisce la propria probabilità. La confidence non va letta automaticamente come percentuale di risposte corrette. È un segnale da verificare sui dati aziendali prima di usarlo per distinguere automazione e revisione.
La scheda ufficiale di Jev 1.13 indica 0,042 dollari per milione di token in ingresso e nessun addebito per l’output. Con un’ipotesi di 100 milioni di token fatturati, il solo consumo del modello sarebbe quindi 4,20 dollari. È un calcolo illustrativo: integrazione, preparazione dei dati e gestione degli errori restano costi del progetto.
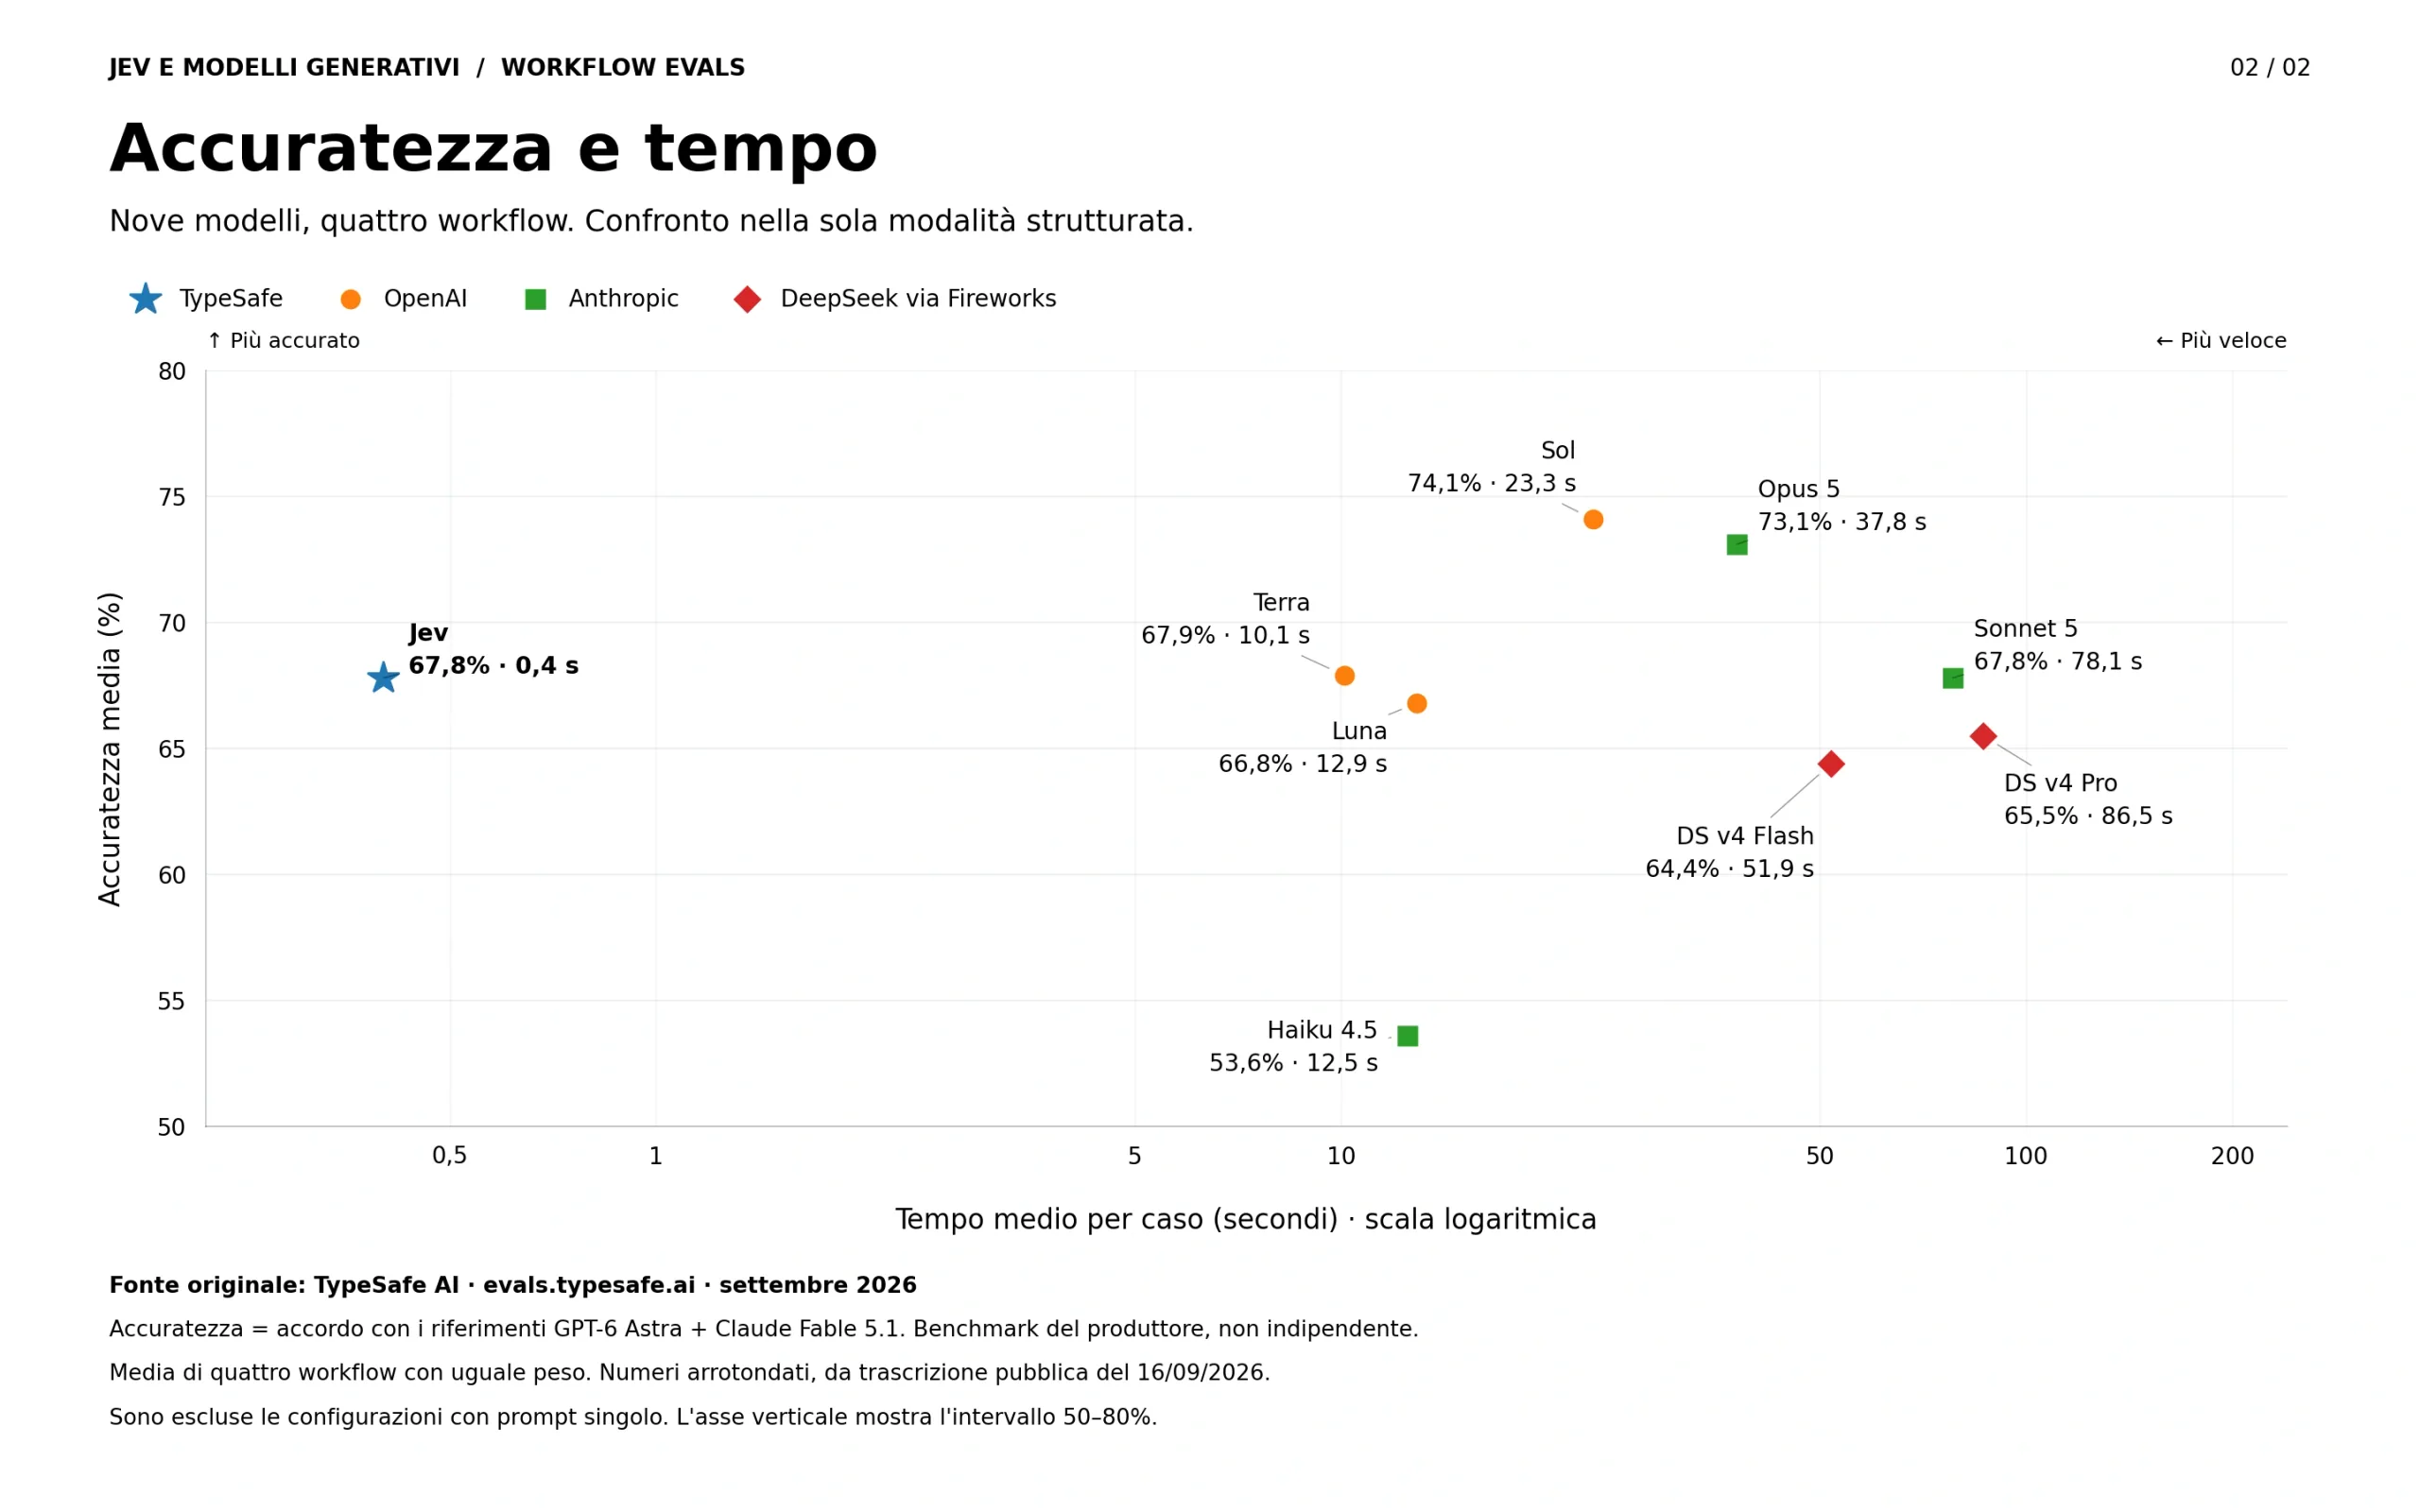
TypeSafe pubblicizza anche forti vantaggi di velocità e costo nei propri confronti. Le valutazioni descritte al lancio riguardano flussi specifici e usano risposte di altri modelli come riferimento. Offrono indicazioni da approfondire; non dimostrano che un processo aziendale avrà lo stesso risparmio.
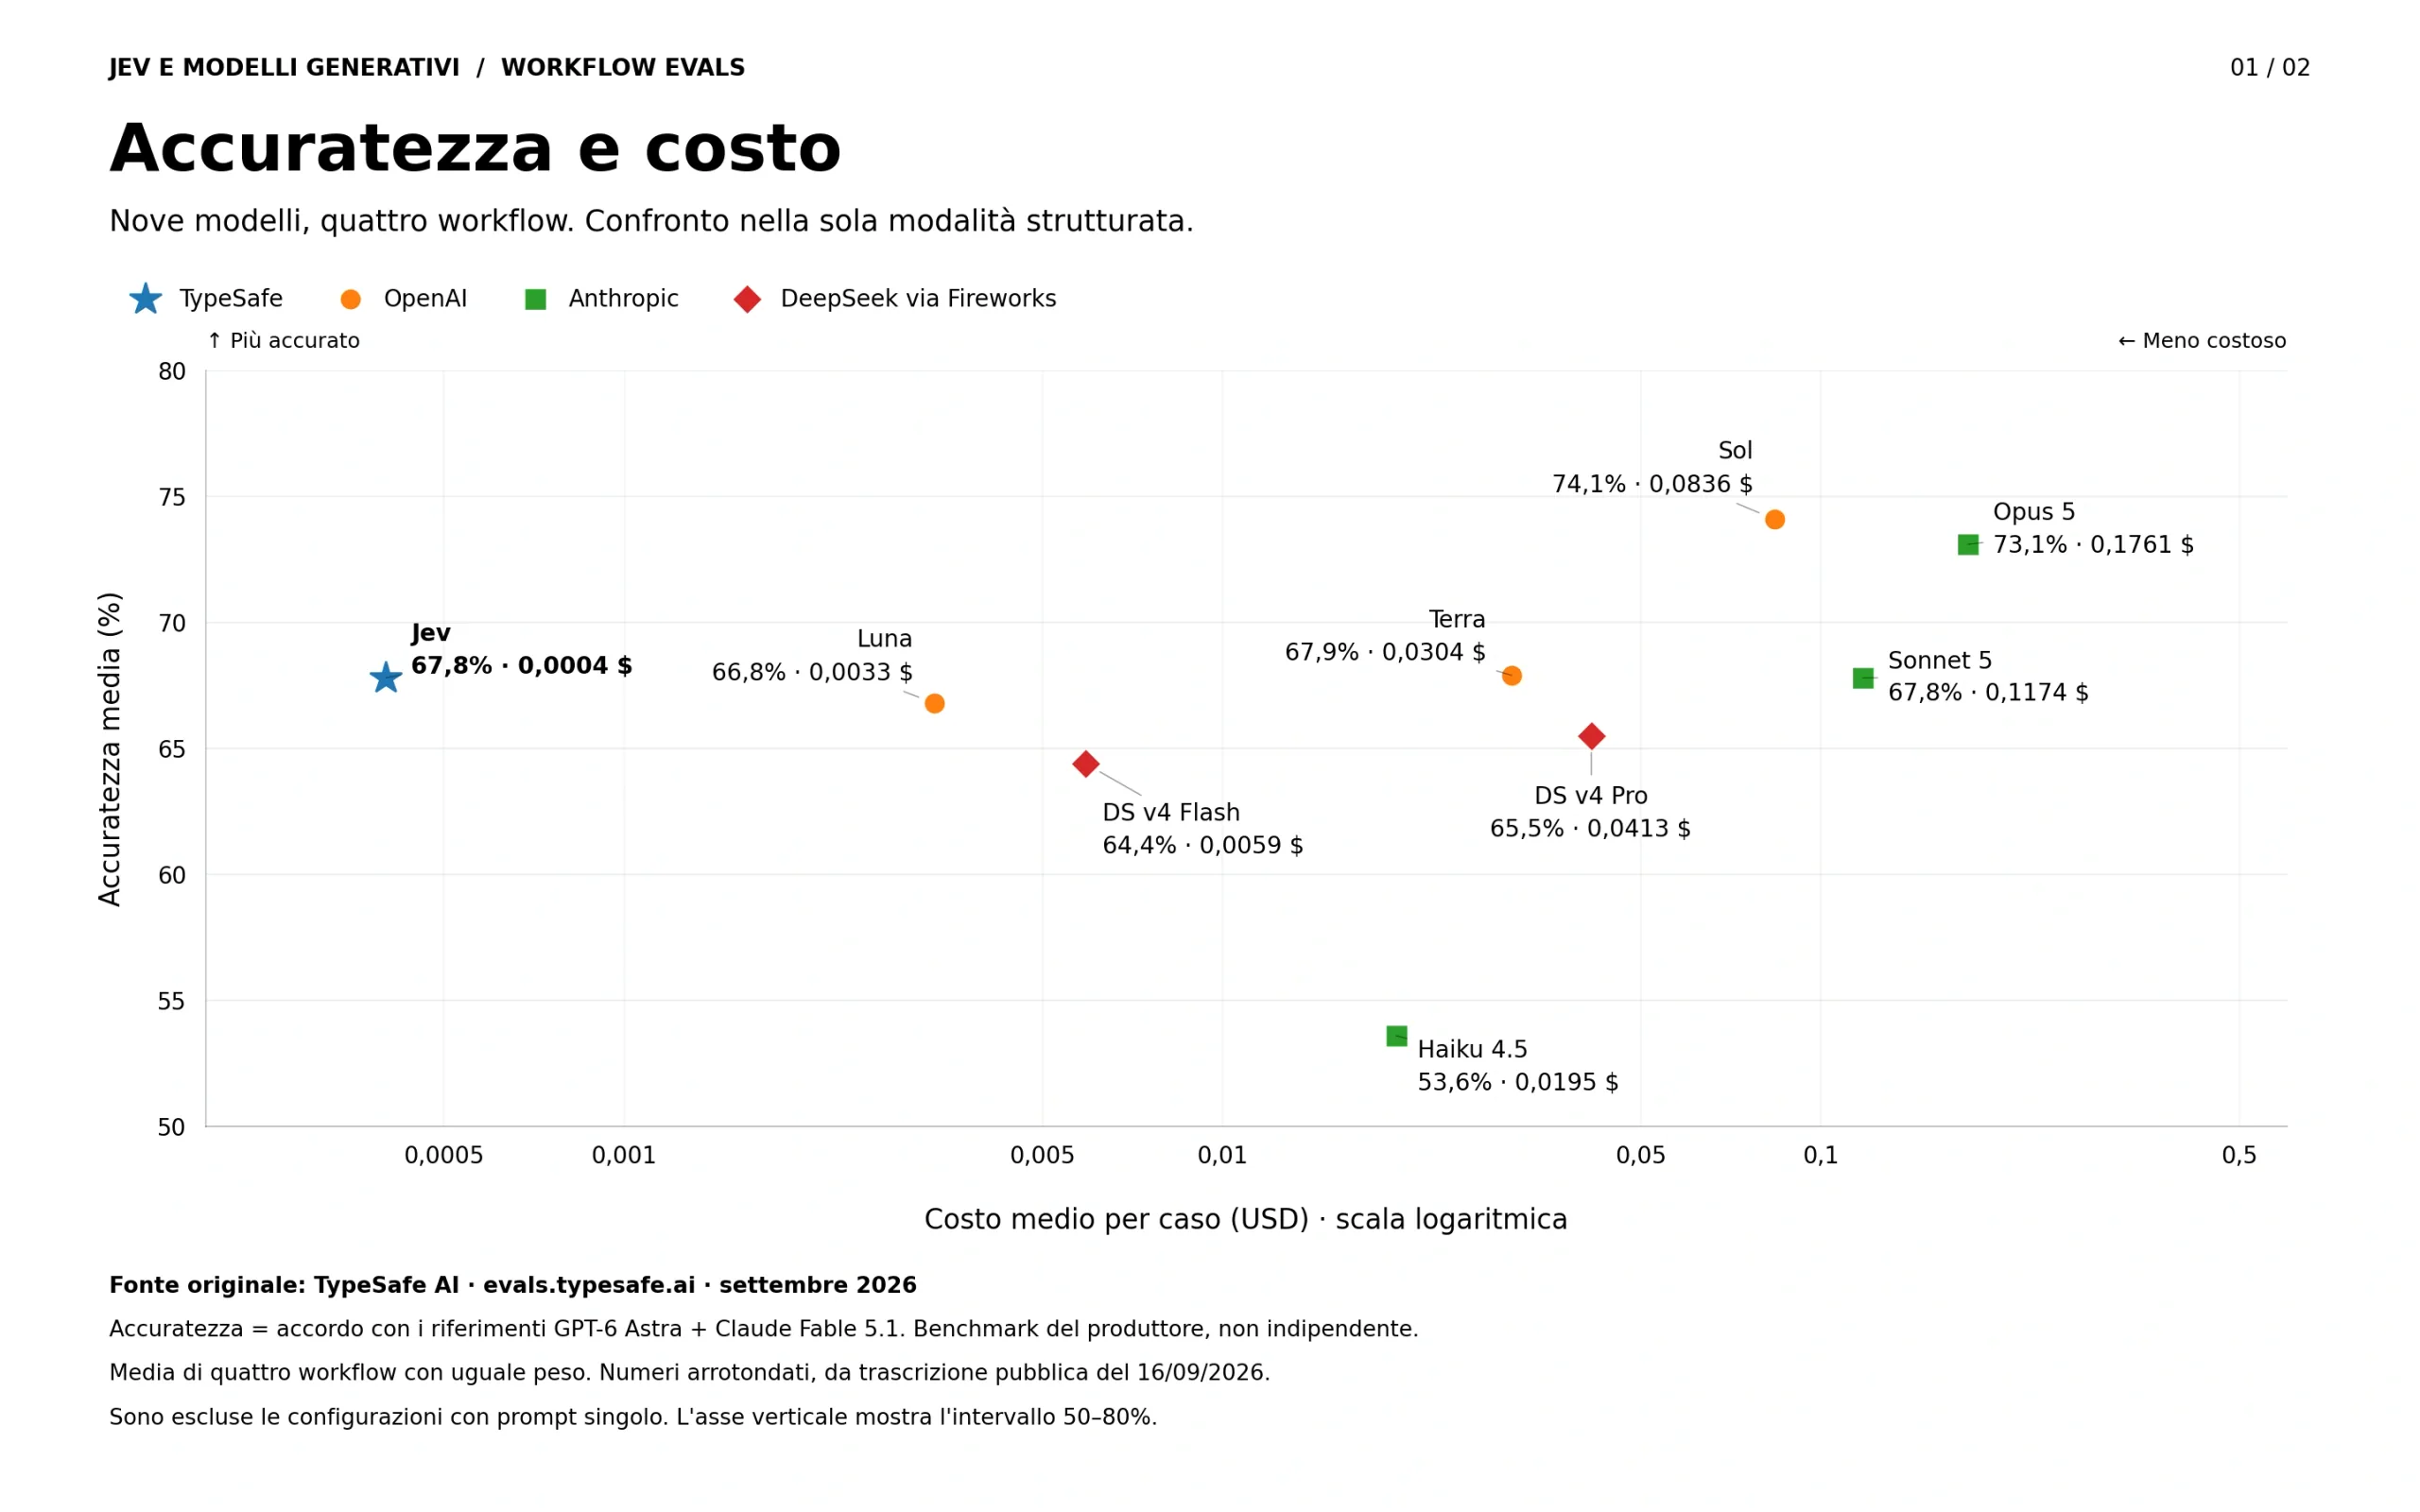
Il confronto economicamente utile misura il costo di un caso gestito correttamente. Una soluzione economica per chiamata può perdere convenienza se costringe gli operatori a correggere molte assegnazioni.
Dove incontra i suoi limiti
La documentazione dei limiti di Jev 1.13, aggiornata il 17 settembre 2026, segnala difficoltà con calcoli, date, ragionamenti indiretti e contesti pieni di dettagli irrilevanti. Descrive inoltre la possibilità che contenuti ostili influenzino la risposta. Jev non genera testo libero.
La versione esaminata riceve soltanto testo; immagini, audio e video richiedono una preparazione esterna. TypeSafe indica inoltre l’inglese come lingua in cui l’accuratezza è migliore. Per un’azienda italiana, verificare messaggi reali, abbreviazioni e terminologia di settore è quindi parte della valutazione.
“Zero allucinazioni” non significa “zero errori”
Nel materiale di lancio, TypeSafe riconduce lo zero dichiarato alla conformità dello schema. Una risposta può rispettare perfettamente il formato ed essere sbagliata: nell’esempio del gestionale, “amministrazione” potrebbe essere una categoria ammessa ma un’assegnazione errata.
Per questo una probabilità elevata non sostituisce autorizzazioni, controlli o approvazioni. Conviene separare una raccomandazione reversibile, come suggerire una coda, da un’azione con conseguenze più difficili da correggere. La scelta dei controlli appartiene al progetto.
Jev e le alternative a confronto
Il confronto riguarda modelli e API, non gli abbonamenti alle applicazioni di chat. Inoltre, un modello generativo può già restituire valori strutturati: gli Structured Outputs di OpenAI, per esempio, possono vincolare la risposta a uno schema supportato. Anche un risultato strutturato richiede verifiche sul suo significato.
Per orientarsi, ecco le differenze utili al nostro caso aziendale:
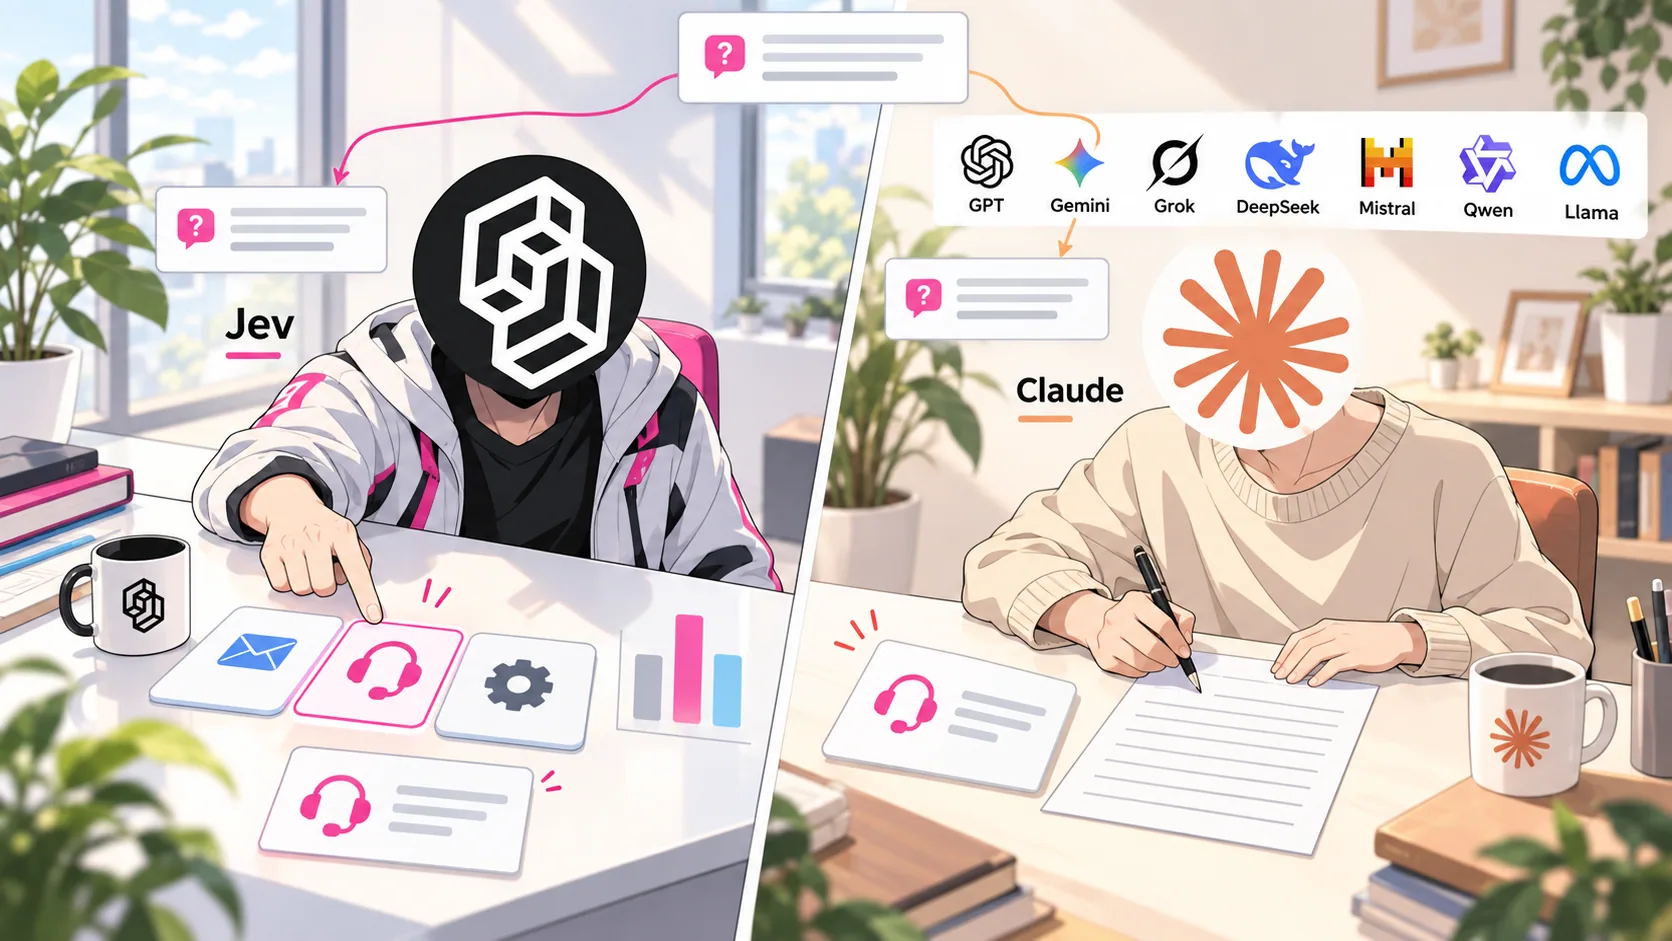
GPT: può combinare generazione di testo e risposte strutturate. È un candidato quando la stessa applicazione deve classificare una richiesta e preparare una risposta; Jev va valutato sulla sola parte decisionale, misurandone il vantaggio.
Claude: offre output JSON strutturati e uso rigoroso degli strumenti. Il formato prevedibile non è quindi un’esclusiva di Jev. Nell’integrazione vanno gestiti anche rifiuti, risposte interrotte e i limiti documentati dello schema.
Gemini: supporta output strutturati nei modelli compatibili. La documentazione distingue esplicitamente correttezza sintattica e correttezza dei valori: un criterio da applicare anche quando si valuta Jev.
Grok: documenta output vincolati a schemi supportati. Per un flusso già costruito sulle sue API, aggiungere Jev dovrebbe produrre un beneficio misurabile che giustifichi un ulteriore servizio.
DeepSeek: la modalità JSON documentata produce JSON valido, con cautele su output vuoti o troncati. Questo da solo non equivale a garantire ogni vincolo dello schema o la correttezza della classificazione.
Mistral, Qwen e Llama: comprendono varianti eseguibili con infrastruttura propria tramite motori come vLLM. La scelta richiede di verificare modello, licenza, hardware e supporto effettivo; offre un diverso equilibrio fra controllo e lavoro operativo.
Il catalogo dei modelli supportati da vLLM documenta quest’ultima possibilità. Avere i pesi disponibili non elimina i costi: qualcuno deve gestire capacità, aggiornamenti e qualità del servizio.
Per Jev, il possibile vantaggio è specializzare le decisioni ripetitive. Il compromesso è aggiungere un componente da integrare e valutare, che non copre la generazione. Non emerge un vincitore universale: una scelta affidabile richiede la stessa attività, gli stessi dati e criteri di successo condivisi.
Quando adottarlo e quando affiancarlo
La nostra raccomandazione è partire da un’attività circoscritta, con volumi e risultati osservabili. Per esempio, proporre il reparto di un ticket prima che l’operatore lo confermi. Conservare il confronto fra suggerimento e assegnazione finale aiuta a capire dove il sistema funziona e dove richiede correzioni.
Un esperimento utile dovrebbe includere:
Un campione rappresentativo, con casi chiari, ambigui e fuori categoria.
Il confronto con il processo attuale, regole semplici e almeno un’alternativa AI pertinente.
Misure di errori, tempi, costo complessivo e frequenza delle revisioni.
Controlli sugli accessi ai dati e sulle azioni consentite, separati dal giudizio del modello.
Una verifica successiva quando cambiano modello, istruzioni o categorie aziendali.
Se l’esigenza principale è scrivere, conversare o costruire una spiegazione complessa, serve un modello generativo. Se occorre scegliere spesso fra esiti definiti, Jev può meritare una sperimentazione. Nei processi misti, la combinazione dei due può essere più sensata della sostituzione completa.
Il valore della consulenza AI sta nel tradurre queste possibilità in un processo verificabile: scegliere che cosa automatizzare, misurare gli errori e stabilire quando deve intervenire una persona.
Vuoi capire quali decisioni del tuo processo possono essere automatizzate? Parlane con IASolutions per valutare dati, strumenti e criteri di controllo.
Punti chiave
- Jev è un componente da integrare nel software: le azioni restano sotto il controllo dell’applicazione.
- La conformità del formato non garantisce che la decisione sia corretta.
- Il confronto con le alternative deve misurare lo stesso compito sui dati aziendali.
- Il costo complessivo comprende integrazione e correzione degli errori, oltre al consumo del modello.
- Per processi che richiedono anche scrittura, valuta l’abbinamento con un modello generativo.
Domande frequenti
Jev può sostituire ChatGPT in azienda?
Dipende dall’attività. Per conversare e scrivere serve un modello generativo. Jev può essere valutato per singoli passaggi decisionali in un’applicazione, come suggerire una categoria o una destinazione.
Che cosa significa “zero allucinazioni” per Jev?
Nel materiale di lancio, TypeSafe lega lo zero alla conformità dello schema. Una categoria ammessa può comunque essere quella sbagliata: occorre verificare la correttezza della decisione.
Come si valuta se Jev conviene?
Con un campione rappresentativo e un confronto con il processo attuale e alternative pertinenti. Misura errori, tempi, costo totale e casi da rivedere, mantenendo gli stessi criteri di successo.
È un confronto basato su test di IASolutions?
No. L’articolo analizza documentazione ufficiale consultata il 24 settembre 2026. Gli esempi aziendali sono illustrativi e i risultati del produttore non vengono presentati come misurazioni indipendenti.
Fonti
- TypeSafe AI — Introducing System One Models & Jev, 15 settembre 2026
- TypeSafe AI — Models: Jev 1.13; consultato il 24 settembre 2026
- TypeSafe AI — Jev 1.13 jaggedness, revisione 17 settembre 2026
- TypeSafe AI — Confidence; consultato il 24 settembre 2026
- OpenAI — Structured model outputs; consultato il 24 settembre 2026
- Anthropic — Structured outputs; consultato il 24 settembre 2026
- Google — Gemini structured outputs; consultato il 24 settembre 2026
- DeepSeek — JSON Output; consultato il 24 settembre 2026
- xAI — Structured Outputs; consultato il 24 settembre 2026
- vLLM — Supported Models; consultato il 24 settembre 2026